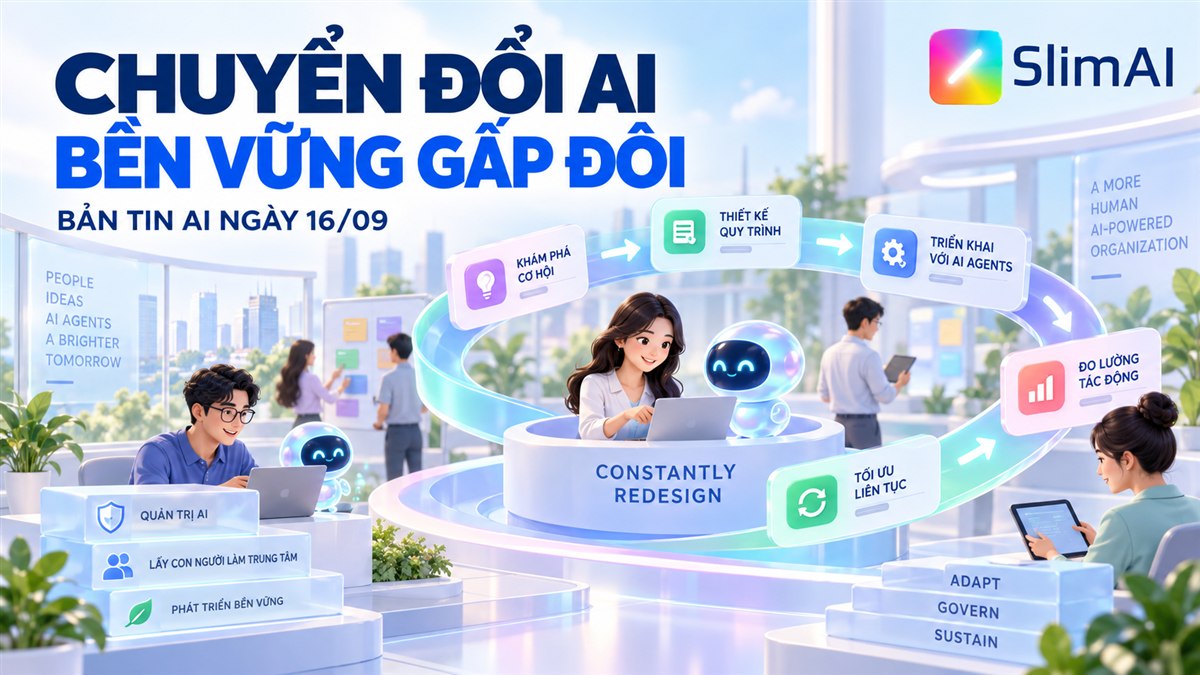
Doanh nghiệp thường coi triển khai AI là một dự án có ngày bắt đầu và kết thúc. Gartner cho rằng cách tiếp cận đó không còn phù hợp: đến năm 2028, tổ chức xây được năng lực thiết kế lại công việc liên tục có khả năng duy trì chuyển đổi dựa trên AI cao gấp đôi. Bản tin hôm nay cũng cho thấy vì sao năng lực vận hành quan trọng hơn một lần thử nghiệm thành công: nghiên cứu của IBM phát hiện một AI Agent có thể đạt tỷ lệ hoàn thành trung bình 77,4% nhưng chỉ làm đúng cả năm lần liên tiếp ở 53% nhiệm vụ.
Tóm tắt 30 giây
- Gartner dự báo doanh nghiệp thiết kế lại quy trình, quyền quyết định và cách bố trí nhân lực một cách liên tục sẽ có khả năng duy trì chuyển đổi AI cao gấp đôi vào năm 2028.
- 64% lãnh đạo kiểm toán trong khảo sát Gartner cho biết việc phát hiện rủi ro trước khi gây ảnh hưởng đáng kể đang khó hơn.
- IBM Research cho thấy điểm trung bình có thể che giấu sự thiếu ổn định của AI Agent: 77,4% thành công trung bình nhưng chỉ 53% nhiệm vụ thành công trong cả năm lần chạy.
- Gemini 3.8 Live và bản Extended Thinking hỗ trợ hội thoại giọng nói, hình ảnh thời gian gần thực và gọi công cụ trong nền.
- AWS cho biết prompt caching có thể giảm tới 90% chi phí token đầu vào khi cùng một ngữ cảnh được dùng lặp lại.
- GitHub Copilot bắt đầu gợi ý giá trị thuộc tính để doanh nghiệp phân loại và áp quy tắc quản trị kho mã nhất quán hơn.
1. Góc nhìn chiến lược: AI buộc doanh nghiệp thiết kế lại cách làm việc liên tục
1.1. Không thể thiết kế quy trình một lần rồi giữ nguyên
Gartner dự báo đến năm 2028, các tổ chức coi việc thiết kế lại công việc liên tục là năng lực cốt lõi sẽ có khả năng duy trì chuyển đổi dựa trên AI cao gấp đôi.
Gartner gọi cách làm này là dynamic redesign — năng lực liên tục điều chỉnh quy trình, quyền quyết định, vai trò công việc và cách bố trí nhân lực khi khả năng AI hoặc ưu tiên kinh doanh thay đổi. Thay vì chờ một dự án chuyển đổi lớn, doanh nghiệp quan sát công việc thực tế rồi cải tiến theo vòng lặp ngắn.
| Thành phần cần quan sát | Câu hỏi dành cho người quản lý |
|---|
| Quy trình | Bước nào đang tắc, lặp lại hoặc chưa tạo ra giá trị? |
| Quyền quyết định | AI được tự xử lý đến đâu và khi nào phải chuyển cho con người? |
| Nhân lực | Kỹ năng nào cần đào tạo lại khi Agent nhận thêm việc? |
| Giám sát Agent | Agent có làm đúng, ổn định và để lại nhật ký kiểm tra hay không? |
Hàm ý quản trị: mục tiêu không phải đưa AI vào càng nhiều bước càng tốt. Doanh nghiệp cần đo luồng công việc thật, giao rõ trách nhiệm giữa người và Agent, rồi điều chỉnh đều đặn dựa trên kết quả.
Giới hạn bằng chứng: con số “gấp đôi” là dự báo của Gartner cho năm 2028; thông báo công khai không nêu quy mô mẫu hoặc phương pháp định lượng. Nên xem đây là định hướng chiến lược cần được kiểm chứng bằng chỉ số nội bộ của từng doanh nghiệp.
1.2. 64% lãnh đạo kiểm toán thấy khó phát hiện rủi ro sớm hơn
Trong khảo sát tháng 4/2026 với 108 lãnh đạo kiểm toán, 64% cho biết việc nhận ra vấn đề trước khi chúng gây ảnh hưởng đáng kể đang khó hơn. Chỉ khoảng 30% lãnh đạo đơn vị kinh doanh nói khả năng quản trị rủi ro của họ chịu ảnh hưởng lớn từ thông tin do kiểm toán, tuân thủ và quản trị rủi ro cung cấp.
Điểm đáng chú ý là thêm báo cáo chưa chắc giải quyết được vấn đề. Gartner đề xuất biến kiến thức quản trị rủi ro thành hướng dẫn và công cụ hỗ trợ quyết định nằm ngay trong quy trình làm việc; AI có thể giúp phổ biến kiến thức đó, nhưng trách nhiệm cuối cùng vẫn cần được xác định rõ.
2. Nghiên cứu thực tế: AI Agent làm đúng một lần chưa có nghĩa là đáng tin
IBM Research công bố nghiên cứu về độ nhất quán của AI Agent trên 168 nhiệm vụ AppWorld. Agent ReAct dùng GPT-4.1 đạt tỷ lệ thành công trung bình 77,4% qua năm lần chạy, nhưng chỉ 53% nhiệm vụ thành công trong cả năm lần. Khoảng cách 24,4 điểm phần trăm này cho thấy một chỉ số trung bình đẹp vẫn có thể che giấu rủi ro “lúc đúng, lúc sai”.
Nhóm nghiên cứu xây Consistency Analyzer để tìm các bước ra quyết định dễ thay đổi. Công cụ lấy một chuỗi hành động đã ghi lại, thử lại từng điểm quyết định theo cách có kiểm soát, rồi tạo hướng dẫn cụ thể cho Agent. Trong thử nghiệm, khoảng cách nhất quán giảm từ 24,4 xuống 12 điểm phần trăm mà không làm giảm độ chính xác trung bình.
| Chỉ số | Kết quả | Ý nghĩa dễ hiểu |
|---|
| Mean@5 | 77,4% | Tỷ lệ thành công trung bình qua năm lần chạy. |
| Pass^5 | 53,0% | Tỷ lệ nhiệm vụ thành công trong cả năm lần. |
| Khoảng cách nhất quán | 24,4 → 12,0 điểm | Hướng dẫn có mục tiêu giúp giảm mạnh mức “lúc đúng, lúc sai”. |
Bài học thực tế: khi kiểm thử Agent, hãy chạy cùng một nhiệm vụ nhiều lần và đo tỷ lệ thành công liên tiếp. Với tác vụ tài chính, pháp lý hoặc vận hành quan trọng, một lần trình diễn thành công không đủ để đưa vào sản xuất.
Giới hạn: đây là kết quả trên benchmark AppWorld với một cấu hình Agent và model cụ thể. Kết quả không tự động đại diện cho mọi Agent hoặc quy trình doanh nghiệp.
3. Cập nhật chính thức từ hãng
3.1. Google ra mắt Gemini 3.8 Live và Extended Thinking
Google giới thiệu hai model hội thoại trực tiếp mới. Gemini 3.8 Live ưu tiên tốc độ và hiệu quả chi phí; bản Extended Thinking dành cho nhiệm vụ phức tạp, có nhiều bước suy luận.
Google cho biết model có thể xử lý hình ảnh ở thời gian gần thực, tự chuyển giữa 97 ngôn ngữ và gọi công cụ hoặc API trong nền mà không làm gián đoạn cuộc trò chuyện. Extended Thinking có thể vừa suy luận vừa phản hồi tiến độ bằng giọng nói. Audio do sản phẩm AI của Google tạo ra được gắn dấu SynthID để hỗ trợ nhận biết nội dung do AI tạo.
Hai model bắt đầu được triển khai qua Gemini API và Google AI Studio; một số khả năng dành cho doanh nghiệp đang ở chế độ thử nghiệm riêng. Các điểm benchmark do Google công bố cần được xem cùng model card và thử nghiệm trên tình huống thực tế của doanh nghiệp.
3.2. AWS: prompt caching có thể giảm tới 90% chi phí token đầu vào
Hướng dẫn mới của AWS mô tả sáu cách dùng prompt caching trong Amazon Bedrock. Prompt caching là cơ chế lưu phần ngữ cảnh đã xử lý, chẳng hạn tài liệu dài, hướng dẫn hệ thống hoặc danh sách công cụ, để model không phải đọc lại từ đầu ở những yêu cầu tiếp theo.
AWS cho biết token đọc từ bộ nhớ đệm có giá thấp hơn tới 90% so với token đầu vào chuẩn. Trong ví dụ một tài liệu 10.000 token được hỏi mười lần, mức tiết kiệm ròng ước tính khoảng 75% vì lần đầu vẫn phải trả chi phí ghi bộ nhớ đệm. Hiệu quả phụ thuộc vào nội dung lặp lại, thời hạn lưu và tỷ lệ truy cập trúng bộ nhớ đệm.
3.3. GitHub Copilot hỗ trợ chuẩn hóa thuộc tính kho mã
GitHub Copilot hiện có thể gợi ý giá trị cho thuộc tính tùy chỉnh khi quản trị viên tạo cách phân loại kho mã ở cấp tổ chức hoặc doanh nghiệp. Ví dụ, thuộc tính tuân thủ FedRAMP có thể được gợi ý các mức phù hợp; thuộc tính “có kết nối Internet” có thể dùng giá trị có hoặc không.
Tính năng đang ở bản xem trước công khai cho Copilot Business và Copilot Enterprise. Lợi ích chính không nằm ở việc điền biểu mẫu nhanh hơn, mà ở việc giúp một tổ chức dùng cùng hệ thống nhãn để áp quy tắc quản trị nhất quán trên nhiều kho mã.
4. Doanh nghiệp nên làm gì trong tuần này?
- Chọn một quy trình thật: ghi lại thời gian, số lỗi và điểm chờ trước khi thêm AI.
- Chạy cùng bài kiểm thử nhiều lần: đo xem Agent có thành công liên tiếp hay chỉ đạt điểm trung bình cao.
- Quy định điểm bàn giao: nêu rõ quyết định nào Agent được tự làm và quyết định nào cần người phê duyệt.
- Đưa quản trị vào luồng làm việc: hướng dẫn rủi ro nên xuất hiện đúng lúc nhân viên ra quyết định, thay vì nằm trong một tài liệu dài ít người đọc.
- Tối ưu chi phí có điều kiện: chỉ bật bộ nhớ đệm cho ngữ cảnh lặp lại, sau đó đo tỷ lệ truy cập trúng và chi phí thực.
- Thiết kế lại theo vòng lặp: mỗi tháng xem lại quy trình, vai trò và quyền hạn khi Agent thay đổi khả năng.
5. Nguồn tham khảo trực tiếp
Chú thích thuật ngữ
- AI Agent: hệ thống AI có thể chọn bước và dùng công cụ để hoàn thành một mục tiêu.
- API: cổng kết nối giúp các phần mềm trao đổi dữ liệu và lệnh với nhau.
- Benchmark: bộ bài kiểm tra chuẩn dùng để so sánh khả năng của các hệ thống.
- Prompt caching: lưu lại phần nội dung model đã xử lý để tái sử dụng, giúp giảm thời gian và chi phí khi ngữ cảnh lặp lại.
- Token: đơn vị nhỏ mà model dùng để đọc và tạo nội dung; chi phí API thường được tính theo số token.
- Model card: tài liệu mô tả khả năng, giới hạn và cách đánh giá một model AI.
Bản tin được tổng hợp và phân phối tự động bằng AIWeb – nền tảng web tự vận hành bằng AI Agent.